در عصری که هوش مصنوعی بهسرعت در حال ورود به پژوهش علمی، تحلیلهای مالی و تصمیمسازیهای سازمانی است، یک پرسش بنیادین بیش از هر زمان دیگری اهمیت یافته است: آیا میتوان به دادههایی که ماشین تولید میکند اعتماد کرد؟
ظاهر اعداد اغلب قانعکننده است؛ منظم، تمیز و بهظاهر «علمی». اما ریاضیات، برخلاف انسان، فریب زیبایی را نمیخورد.
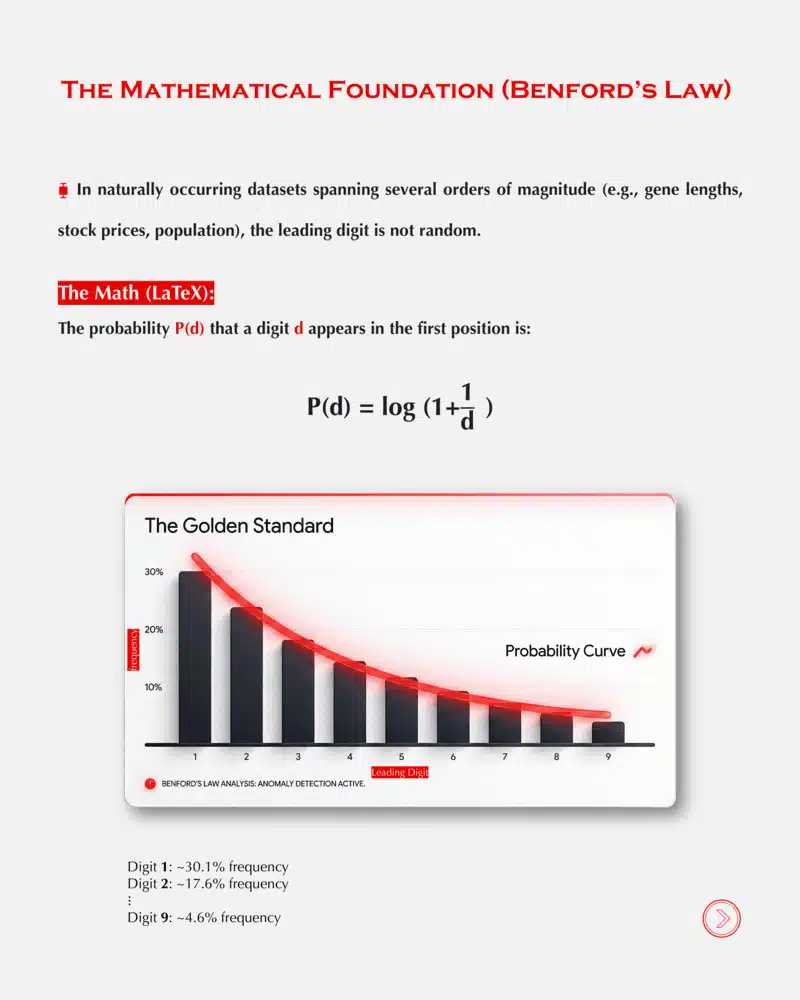
یکی از ابزارهای کلاسیک اما قدرتمند برای تشخیص دادههای طبیعی از دادههای مصنوعی، قانون بنفورد (Benford’s Law) است؛ قانونی آماری که نشان میدهد در بسیاری از دادههای دنیای واقعی، توزیع رقم اول اعداد یکنواخت نیست. برخلاف انتظار شهودی، عدد ۱ با فراوانی حدود ۳۰٪ ظاهر میشود، درحالیکه عدد ۹ تنها حدود ۴.۶٪ رخ میدهد. این الگوی لگاریتمی، امضای ریاضی فرآیندهای طبیعی و اقتصادی است.
طبق توضیح ارائهشده در فایل تحلیلی «Math Doesn’t Trust AI»، دادههایی که از فرآیندهای واقعی مانند رشد جمعیت، قیمت سهام، طول ژنها یا نتایج آزمایشگاهی حاصل میشوند، از این قانون تبعیت میکنند، زیرا محصول فرآیندهای ضربی و مقیاسناوردا هستند. به بیان ساده، اگر یک پدیده را با واحدهای متفاوت (مثلاً متر یا کیلومتر) اندازهگیری کنیم، توزیع رقم اول همچنان ثابت میماند. این خاصیت، چیزی نیست که بهسادگی قابل جعل باشد.
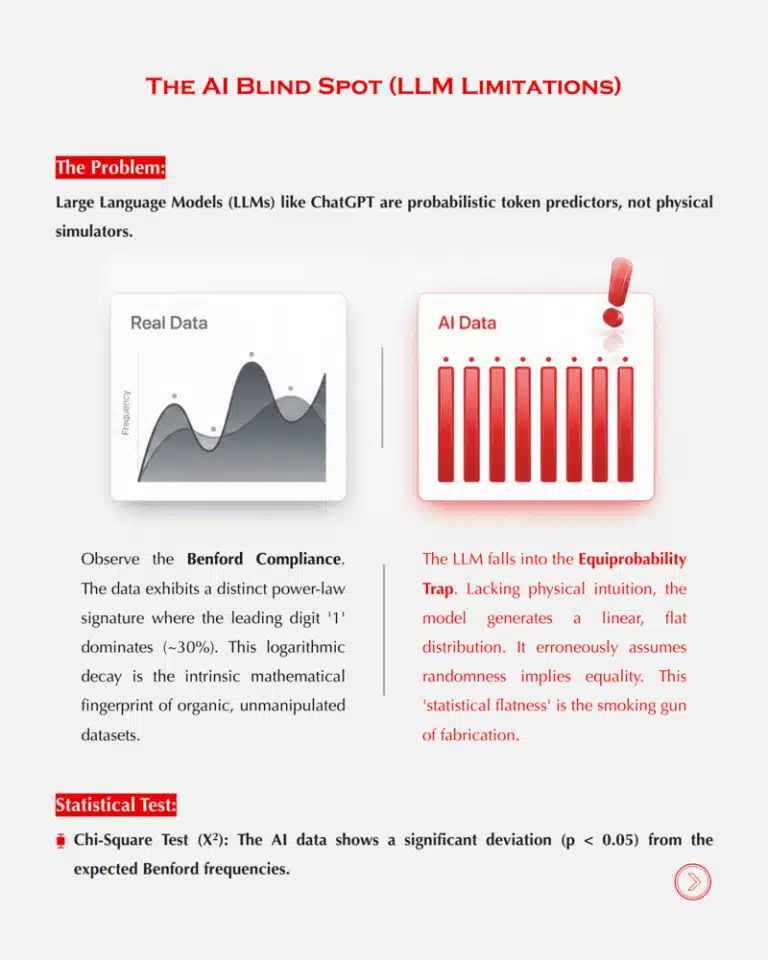
مسأله از جایی آغاز میشود که مدلهای زبانی بزرگ (LLMs) وارد تولید داده عددی میشوند. این مدلها، از جمله ChatGPT، شبیهساز فیزیک یا واقعیت نیستند؛ آنها پیشبینهای احتمالی توکناند. در نتیجه، هنگام تولید داده «تصادفی»، اغلب به دام آنچه «تله برابراحتمالی» (Equiprobability Trap) نامیده میشود میافتند: توزیعی صاف و یکنواخت که در نگاه ریاضی، نشانهای آشکار از ساختگیبودن است.
در تحلیل مقایسهای ارائهشده در فایل، دادههای واقعی یک الگوی توانی با افت لگاریتمی مشخص نشان میدهند، درحالیکه دادههای تولیدشده توسط هوش مصنوعی، توزیعی خطی و تخت دارند. آزمون کایدو (Chi-Square Test) این انحراف را بهطور معنادار تأیید میکند (p < 0.05). این «صافبودن آماری» همان اثر انگشتی است که ریاضیات آن را بهعنوان نشانه جعل شناسایی میکند.
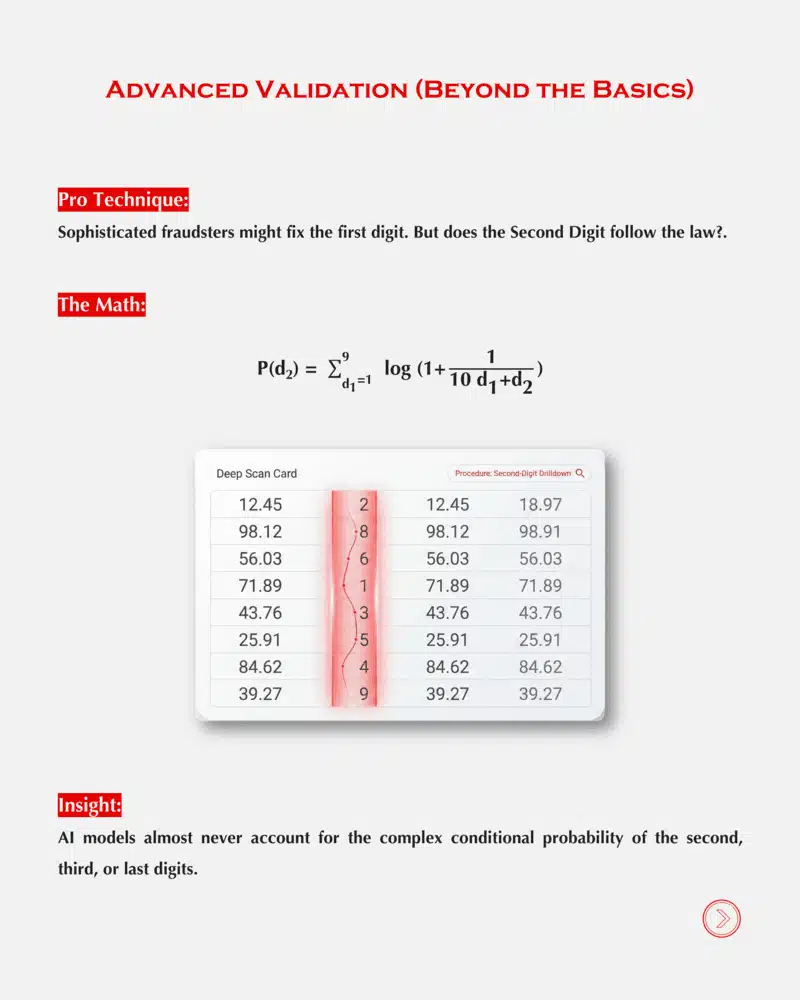
ممکن است جعلکنندگان حرفهای—حتی انسانها یا سیستمهای پیشرفته—رقم اول را اصلاح کنند. اما قانون بنفورد به همینجا ختم نمیشود. بررسی رقم دوم، سوم یا حتی رقم پایانی، نیازمند محاسبات شرطی پیچیدهای است که تقریباً هیچ مدل زبانی بهطور پیشفرض آن را در نظر نمیگیرد. اینجاست که ابزارهای حسابرسی داده، به سلاحی مؤثر در برابر جعل علمی، تقلب مالی و «هالوسینیشن عددی» تبدیل میشوند.
در جهانی که تصمیمهای کلان بر داده استوارند، اعتماد کور به خروجی هوش مصنوعی میتواند پرهزینه باشد. از مقالات علمی تا گزارشهای مالی و پیشبینیهای اقتصادی، نیاز به ابزارهای راستیآزمایی آماری بیش از گذشته احساس میشود. قانون بنفورد یادآور یک اصل بنیادین است:
“هوش مصنوعی میتواند روایت بسازد، اما قوانین طبیعت را بازتولید نمیکند.”
در نهایت، آینده تحلیل داده نه در رد هوش مصنوعی، بلکه در همنشینی آن با ریاضیات سختگیر و ابزارهای فورنزیک آماری رقم میخورد. ریاضیات اعتماد نمیکند؛ بررسی میکند.

