پژوهش علمی هیچوقت به اندازه امروز در دسترس نبوده است. تنها با چند سؤال میتوان در چند ثانیه دهها مقاله، خلاصه، نمودار یا حتی متن آماده دریافت کرد. همین موضوع باعث شده بسیاری از پژوهشگران، دانشجویان و حتی اعضای هیئت علمی، اولین قدم هر پروژه تحقیقاتی را با ابزارهایی مانند ChatGPT یا Perplexity آغاز کنند.
اما تجربه نشان داده است که سرعت بیشتر، همیشه به معنای پژوهش بهتر نیست.
بسیاری از افراد ساعتها میان پاسخهای مختلف جابهجا میشوند، بارها سؤال خود را بازنویسی میکنند و در نهایت متوجه میشوند بخش قابل توجهی از زمانشان صرف جستوجوی اشتباه شده است، نه انجام تحقیق.
مشکل اصلی معمولاً از کیفیت مدلهای هوش مصنوعی یا مهارت در پرامپتنویسی نیست؛ بلکه از این تصور ناشی میشود که یک ابزار باید بتواند تمام مراحل پژوهش را بهتنهایی انجام دهد. در واقع، پژوهش علمی یک Workflow چندمرحلهای است و هر مرحله، ابزار تخصصی خودش را میخواهد.
در این مقاله، فرآیند تحقیق را به شش مرحله تقسیم میکنیم و برای هر مرحله، مناسبترین دسته از ابزارهای هوش مصنوعی را معرفی خواهیم کرد.
پژوهش علمی تنها به یافتن پاسخ یک سؤال محدود نمیشود. پیش از آنکه حتی اولین مقاله را مطالعه کنید، باید بدانید چه مطالعاتی تاکنون انجام شدهاند، کدام پژوهشها معتبرتر هستند، چه شکافهایی در نگارش وجود دارد و آیا اصلاً سؤال تحقیق ارزش دنبال کردن دارد یا خیر.
پس از آن نیز باید اطلاعات موردنیاز را استخراج کنید، دادهها را مقایسه کنید، دانش شخصی خود را سازماندهی کنید و در نهایت متن مقاله را مطابق استانداردهای علمی بازنویسی نمایید.
استفاده از یک ابزار واحد مثل chatgpt، که یک مدل زبانیست، برای تمام این مراحل، شبیه آن است که بخواهید با یک پیچگوشتی، هم دیوار را تخریب کنید، هم لولهکشی انجام دهید و هم کابینت نصب کنید. هر ابزار برای کاری مشخص طراحی شده است.
به همین دلیل مدلهای زبانی در بخشهای مختلف پژوهش محدودیت دارد:
– شبکه استنادها را نمایش نمیدهد.
– اعتبار شواهد را ارزیابی نمیکند.
– در استخراج اطلاعات عددی ممکن است خطا کند.
– برای مرور نظاممند طراحی نشده است.
– پایگاه دانش شخصی ایجاد نمیکند.
اولین مرحله هر پژوهش، یافتن ادبیات علمی مرتبط است.
بزرگترین اشتباه پژوهشگران این است که جستجو را با Keyword آغاز میکنند. در این مرحله، هدف فقط پیدا کردن چند مقاله نیست؛ بلکه باید بتوانید ساختار یک حوزه را درک کنید:
ابزارهایی مانند Connected Papers، ResearchRabbit، Litmaps، Semantic Scholar و OpenAlex دقیقاً برای همین هدف طراحی شدهاند. برخلاف موتورهای جستجوی عمومی، این ابزارها ارتباط میان مقالات را نیز نمایش میدهند و مسیر تکامل یک ایده را آشکار میکنند.
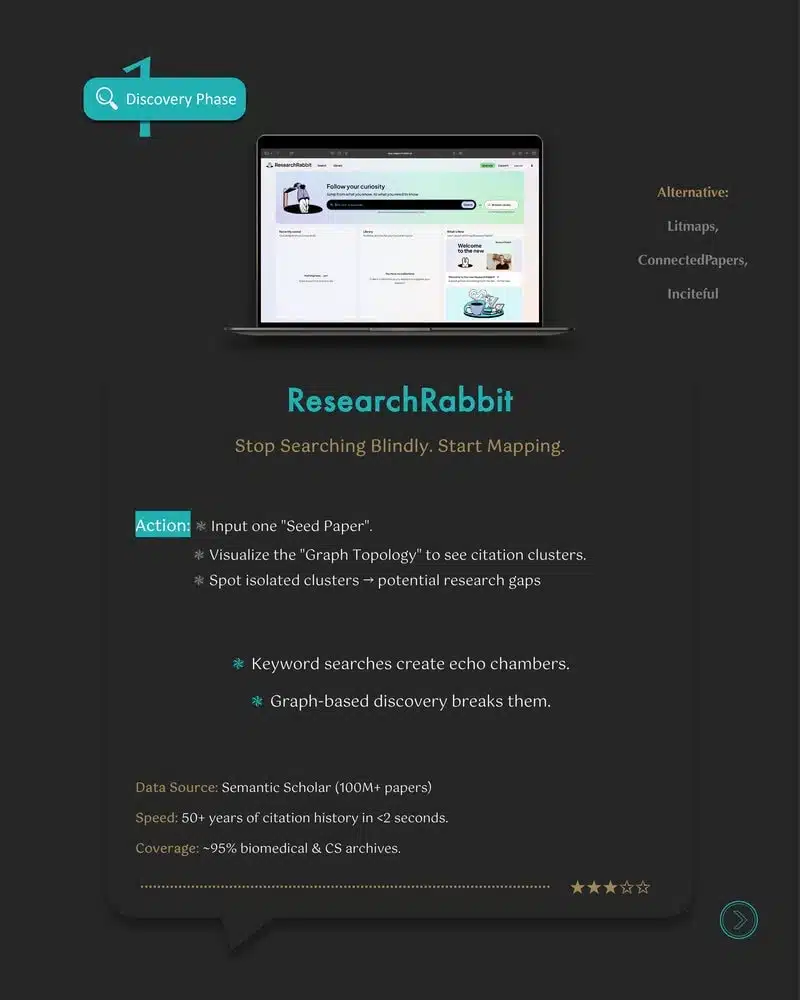
به جای فهرست مقالات، گراف دانش تولید میکند.
با وارد کردن یک Seed Paper میتوانید:
مقالات والد را ببینید.
مقالات فرزند را پیدا کنید.
خوشههای استنادی را کشف کنید.
پژوهشگران فعال حوزه را بشناسید.
شکافهای پژوهشی را شناسایی کنید.
در واقع به جای جستجوی خطی، ساختار یک حوزه علمی را مشاهده میکنید، سرویسهای عمومی براساس کلمات کلیدی جستجو میکنند اما ResearchRabbit براساس ارتباط علمی. به همین دلیل احتمال گرفتار شدن در Echo Chamber بسیار کمتر میشود.
پس از آن نیز باید اطلاعات موردنیاز را استخراج کنید، دادهها را مقایسه کنید، دانش شخصی خود را سازماندهی کنید و در نهایت متن مقاله را مطابق استانداردهای علمی بازنویسی نمایید.
استفاده از یک ابزار واحد مثل chatgpt، که یک مدل زبانیست، برای تمام این مراحل، شبیه آن است که بخواهید با یک پیچگوشتی، هم دیوار را تخریب کنید، هم لولهکشی انجام دهید و هم کابینت نصب کنید. هر ابزار برای کاری مشخص طراحی شده است.
یکی از اشتباهات رایج این است که پژوهشگر ساعتها روی مطالعه یک مقاله زمان صرف میکند، بدون آنکه بداند یافتههای آن تا چه اندازه توسط سایر مطالعات تأیید شده است.
در این مرحله، هدف بررسی میزان اجماع علمی است.
فرض کنید مقالهای ادعا میکند:
«فلان دارو خطر آلزایمر را ۴۰ درصد کاهش میدهد.»
آیا ارزش دارد همان لحظه وقت بگذارید و مقاله را کامل بخوانید؟ نه.
ابتدا باید بدانید:
آیا این نتیجه تکرار شده؟
چند مطالعه آن را تأیید کردهاند؟
کیفیت شواهد چیست؟
ابزارهایی مانند Consensus، Elicit و Scite به شما کمک میکنند تا تنها در چند دقیقه متوجه شوید آیا نتایج یک مقاله توسط سایر پژوهشها تأیید شده، رد شده یا هنوز محل اختلاف است.
این مرحله میتواند ساعتها مطالعه غیرضروری را حذف کند و کیفیت تصمیمگیری پژوهشی را به شکل محسوسی افزایش دهد.
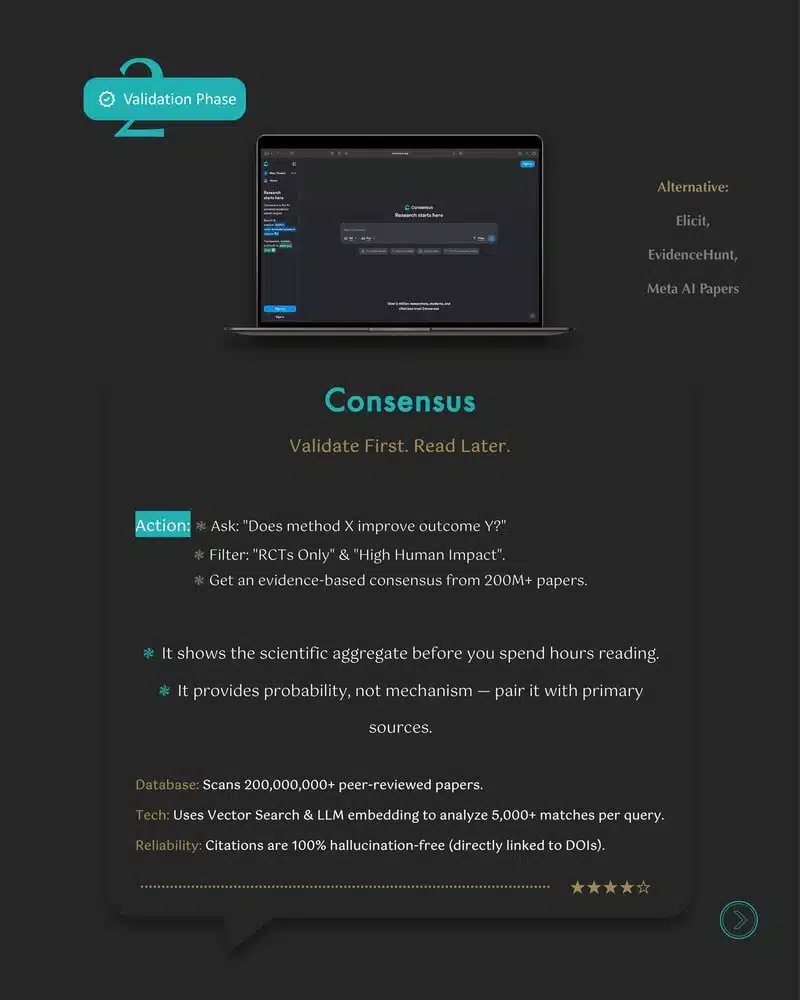
بیش از آنکه موتور جستجو باشد، موتور اجماع علمی است. به جای خلاصه یک مقاله، خلاصه صدها مقاله را ارائه میکند.
مثلاً اگر بپرسید:
Does intermittent fasting improve insulin sensitivity?
ابزار نشان میدهد:
چند درصد مطالعات موافقاند.
کیفیت مطالعات چگونه است.
RCTها چه نتیجهای داشتهاند.
نقاط اختلاف چیست.
این باعث میشود ساعتها مطالعه غیرضروری حذف شود.
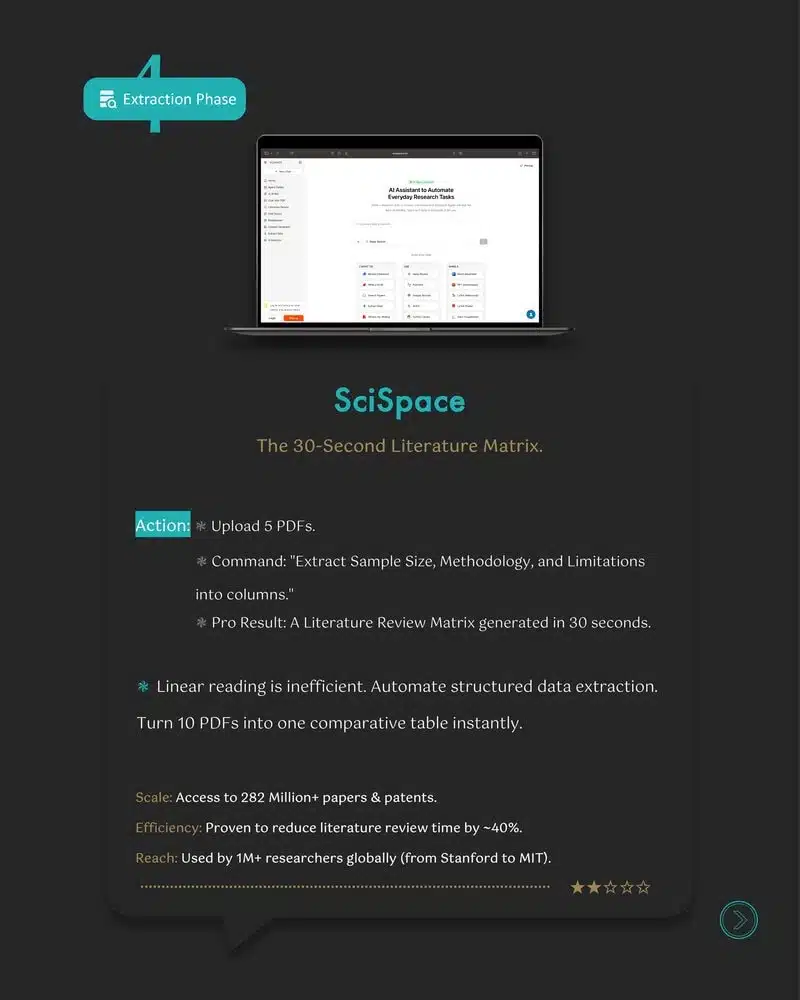
در بسیاری از پروژهها نیازی به مطالعه کامل مقاله نیست. گاهی کل مقاله فقط برای پیدا کردن یک عدد خوانده میشود.
مثلاً:
pH محلول
دوز دارو
اندازه نمونه
الگوریتم آموزش
نرخ موفقیت
جستوجوی دستی این اطلاعات در میان دهها صفحه مقاله، زمانبر و خستهکننده است.
ابزارهایی مانند ChatPDF، SciSpace AI، Humata یا NotebookLM امکان پرسیدن سؤال مستقیم از متن مقاله را فراهم میکنند و پاسخ را همراه با محل دقیق آن در فایل ارائه میدهند.
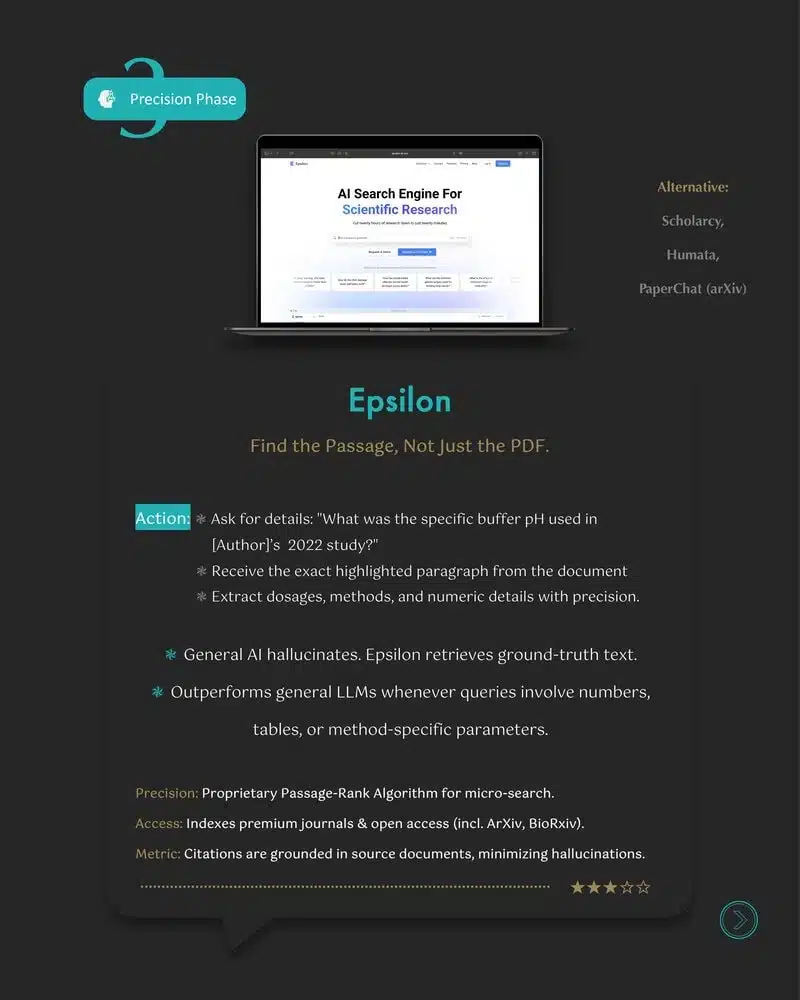
برای پاسخ دادن طراحی نشده است. برای پیدا کردن دقیق پاراگراف طراحی شده است. وقتی سؤال میپرسید، متن اصلی مقاله را پیدا میکند. نه خلاصه مدل زبانی را.
به همین دلیل در استخراج پارامترهای علمی، معمولاً از چتباتهای عمومی دقیقتر عمل میکند.
مطالعه مقاله پایان کار نیست.
برای مرور نظاممند (Systematic Review)، متاآنالیز یا حتی مقایسه چند مطالعه، باید اطلاعات مهم هر مقاله به شکل ساختاریافته استخراج شود. مواردی مانند:
نوع مطالعه، جامعه آماری، حجم نمونه، روش تحقیق، متغیرهای اصلی، نتایج و محدودیتها
ابزارهای مبتنی بر هوش مصنوعی میتوانند این اطلاعات را به جدولهای قابل مقایسه تبدیل کنند و زمان استخراج داده را از چند ساعت به چند دقیقه کاهش دهند.
میتواند:
Sample Size
Methodology
Dataset
Outcome
Limitation
را از چندین مقاله استخراج کند و در قالب جدول ارائه دهد. نتیجه؟ به جای ۵۰ فایل PDF، یک ماتریس مقایسه خواهید داشت
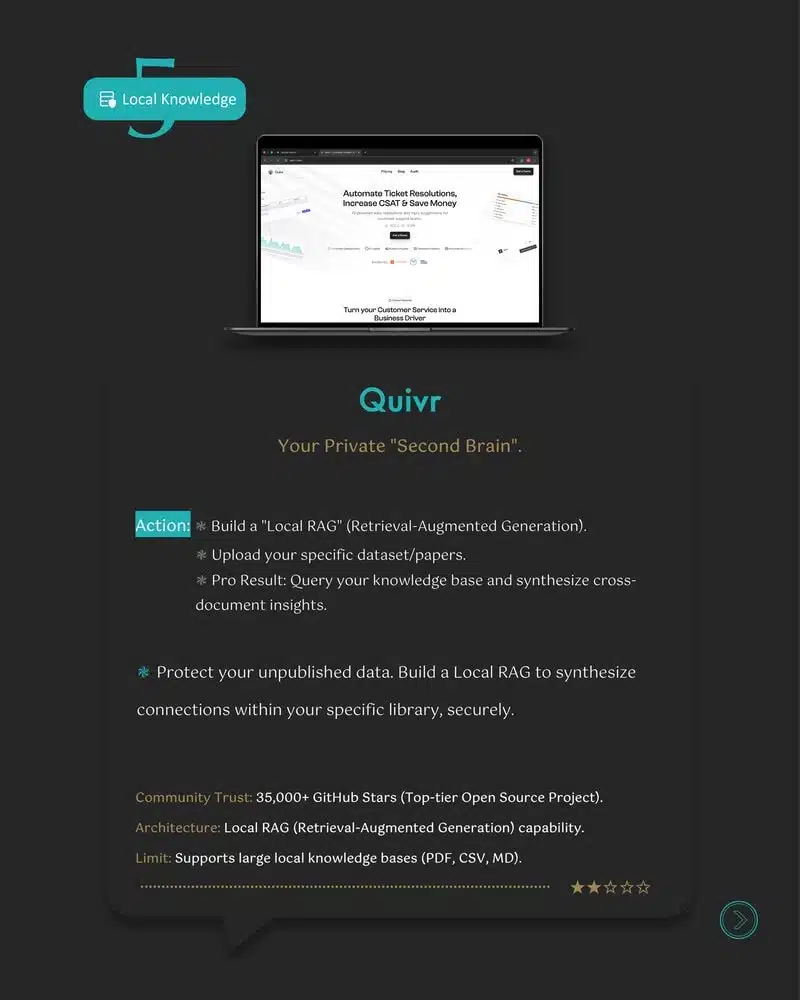
بزرگترین ضعف ChatGPT: این است که دانش شما را نمیشناسد. فرض کنید:
۲۰۰ مقاله،۳۰ گزارش، ۱۰ کتاب، چند فایل آزمایشگاهی دارید. هر بار باید دوباره همه را آپلود کنید.یکی از بزرگترین محدودیتهای سرویسهای عمومی هوش مصنوعی، وابستگی آنها به فضای ابری است. در پروژههای صنعتی، پزشکی یا سازمانی، بسیاری از اسناد محرمانهاند و امکان بارگذاری آنها روی سرویسهای عمومی وجود ندارد.
در چنین شرایطی، استفاده از سیستمهای RAG محلی و ابزارهایی مانند AnythingLLM، Open WebUI یا LM Studio به پژوهشگر اجازه میدهد یک پایگاه دانش اختصاصی ایجاد کند و بدون خروج اطلاعات از سازمان، اسناد خود را جستوجو و تحلیل کند.
این رویکرد علاوه بر حفظ محرمانگی، امکان شخصیسازی کامل دانش را نیز فراهم میکند.
یک Local RAG ایجاد میکند.
یعنی: تمام دانش اختصاصی شما را به یک موتور جستجوی شخصی تبدیل میکند.
مزیت اصلی؟ اطلاعات محرمانه از سازمان خارج نمیشود.
یکی از مهمترین سوءبرداشتها درباره هوش مصنوعی، استفاده از آن برای نوشتن کامل مقاله است.
واقعیت این است که ابزارهای هوش مصنوعی زمانی بهترین عملکرد را دارند که نویسنده، محتوای علمی را خودش تولید کرده باشد و از AI تنها برای بهبود کیفیت نگارش استفاده کند.
در این مرحله میتوان از ابزارهایی مانند ChatGPT، Claude یا DeepL Write برای:
استفاده کرد.
هوش مصنوعی باید نقش ویرایشگر علمی را ایفا کند، نه نویسنده اصلی پژوهش.
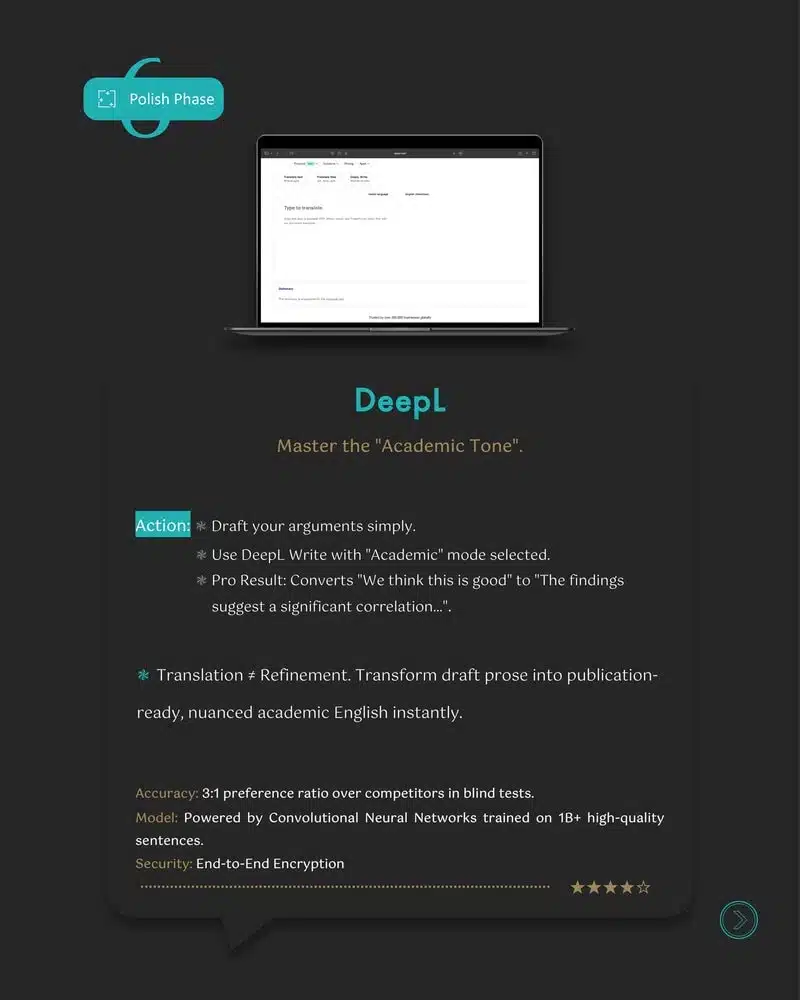
یکی از بهترین ابزارهای Academic Editing است. به جای تولید متن جدید، متن شما را به استانداردهای نگارش علمی نزدیک میکند. روانتر، دقیقتر، رسمیتر و بدون تغییر محتوای علمی. این ابزار در ترجمه متون هم کیفیت بالایی دارد.
اگر بخواهیم کل فرآیند را خلاصه کنیم، یک گردشکار بهینه میتواند به این شکل باشد:
در این رویکرد، هر ابزار تنها مسئول بخشی از مسیر است و همین تقسیم وظایف باعث افزایش دقت، کاهش خطا و صرفهجویی قابل توجه در زمان میشود.
هوش مصنوعی پژوهش را سادهتر کرده است، اما سادهتر شدن به معنای حذف روش علمی نیست.
پژوهش همچنان به تفکر انتقادی، ارزیابی شواهد و انتخاب منابع معتبر وابسته است. تفاوت امروز این است که بسیاری از کارهای زمانبر را میتوان به ابزارهای تخصصی سپرد؛ البته به شرط آنکه بدانیم هر ابزار برای چه مرحلهای طراحی شده است.
در نهایت، موفقترین پژوهشگران کسانی نخواهند بود که از یک مدل هوش مصنوعی بیشتر استفاده میکنند، بلکه کسانی هستند که برای هر مرحله از پژوهش، ابزار مناسب همان مرحله را انتخاب میکنند.
نسخه تصویری و خلاصهشدهی این معرفی در پست لینکدین زیر منتشر شده است: